Sur un produit existant, une partie des règles n'est écrite nulle part dans le code, et un agent IA ne peut pas la deviner. Les agents rendent pourtant la modernisation d'un code legacy moins chère à tenter, à condition de leur écrire ce que le code ne dit pas et de vérifier qu'ils n'ont rien cassé. Zones de risque, tests de caractérisation, migration par morceaux complets : cet article détaille la marche à suivre pour faire travailler des agents IA sur du code legacy.
Une démo d'agent IA qui code une application en une après-midi part d'une page blanche. Le produit sur lequel vous travaillez, lui, a peut-être dix ans de code legacy et des règles métier que personne n'a jamais écrites. Sur ce terrain, un agent peut écrire du code parfaitement correct et se tromper quand même de cible.
Mistral a raconté en septembre l'un de ces chantiers. Un opérateur européen de l'énergie lui avait confié un logiciel de simulation écrit en Fortran 77, un langage des années 1970. La mission consistait à le réécrire en C++, un langage actuel, pour obtenir un code de qualité, plus facile à maintenir.
Le vieux programme avait un défaut de construction typique de son époque : toutes ses données étaient rangées dans une mémoire commune, que n'importe quelle partie du code pouvait lire et modifier. Pour toucher à une fonction, il fallait vérifier tout ce qui utilisait les mêmes données. Moderniser voulait dire réorganiser le programme en blocs séparés, chacun avec ses propres données.
Pour un premier essai, les équipes de Mistral ont laissé des agents traduire le code seuls pendant une semaine. Le logiciel obtenu tournait, et il était bien écrit en C++. Les agents avaient pourtant conservé la mémoire commune telle quelle : le défaut de construction avait simplement changé de langue.
Les agents avaient traduit le code comme on le leur demandait, sans savoir ce qu'il fallait garder de l'ancien programme ni ce qu'il fallait changer. Mistral a fini par réussir la migration en vérifiant que le nouveau programme donnait les mêmes résultats que l'ancien et en remettant la documentation en ordre.
Ce travail des agents IA sur un produit existant est appelle brownfield agentic engineering. Il demande de savoir où ils peuvent intervenir, de leur écrire ce que le code ne dit pas, de figer ce qui fonctionne avant d'y toucher et de migrer par morceaux complets avant d'accélérer.
Au sommaire
- Qu'est-ce que le brownfield agentic engineering ?
- Comment décider où un agent IA a le droit d'intervenir ?
- Que faut-il documenter pour un agent IA sur un produit existant ?
- Comment transformer les corrections répétées en garde-fous ?
- Pourquoi figer le comportement actuel avant d'y toucher ?
- Comment moderniser du code legacy avec des agents IA ?
- Quand faut-il faire travailler plusieurs agents en parallèle ?
- Quels indicateurs suivre pour mesurer l'impact des agents sur un produit existant ?
- FAQ
Qu'est-ce que le brownfield agentic engineering ?
Sur un système qui existe déjà, le code ne raconte pas toute l'histoire. Une partie des règles vit ailleurs : dans la mémoire des équipes, dans des rustines oubliées, dans de vieux services ou dans les attentes d'autres équipes. Travailler avec des agents IA sur ce type de système consiste à rendre ces règles visibles pour l'agent, puis à vérifier qu'un changement ne les a pas cassées.
Le mot vient de l'urbanisme, où un brownfield est une friche industrielle sur laquelle on reconstruit en composant avec ce qui reste. En logiciel, il s'oppose au greenfield, le projet parti de zéro, et désigne le travail sur du legacy.
Un agent comprend plutôt bien l'organisation d'un système en lisant son code. Addy Osmani, qui a travaillé au cours de sa carrière sur plusieurs codebases anciennes, dont celle d'AOL.com, le souligne dans un long texte consacré au sujet, publié mi-septembre. L'agent ne peut pas deviner, en revanche, qu'une règle de calcul a été négociée avec un gros client il y a six ans, ou qu'une autre équipe lit chaque nuit une table de la base de données.
Osmani note aussi que certains considèrent qu'on entre en brownfield dès qu'un agent a écrit du code dont on n'a pas validé chaque décision. On partage cette lecture. Une équipe qui fait du vibe coding depuis six mois sans relire chaque choix a déjà son propre legacy, et elle est aussi concernée par ce qui suit qu'une DSI qui maintient un ERP de vingt ans.
Comment décider où un agent IA a le droit d'intervenir ?
Avant de laisser un agent intervenir sur un produit existant, on classe ses différentes parties selon le risque. Plus une erreur ferait de dégâts, et plus elle serait difficile à repérer ou à annuler, moins l'agent a d'autonomie.
Osmani propose pour cela un découpage en trois zones, selon la qualité des tests existants et la sensibilité métier du code :
| Zone | Ce qu'on y trouve | Ce que l'agent peut faire | Pour changer de zone |
|---|---|---|---|
| Verte | Code récent, bien testé, isolé du reste | Travailler seul, par petites itérations | Aucune condition |
| Jaune | Qualité inégale | Écrire d'abord des tests qui figent le comportement actuel, modifier ensuite | Passe en vert une fois ces tests écrits et les premiers changements relus par le responsable du module |
| Rouge | Connexion des utilisateurs, facturation, droits d'accès, paie, code que peu de personnes comprennent | Rien sans un humain à ses côtés à chaque étape | Disposer d'abord d'un moyen fiable de reproduire l'usage réel |
Pour Osmani, c'est un humain qui doit dessiner cette carte. Laissé libre, écrit-il avec humour, un agent commence par le fichier le plus risqué, parce que c'est celui qui porte les noms les plus intéressants. Ses deux autres règles figurent dans le tableau : une zone ne change de couleur que lorsque c'est mérité, et sa couleur fixe ce que l'agent a le droit de faire.
Dessiner cette carte demande deux types de connaissances. La qualité des tests se mesure côté Tech. La criticité métier se connaît souvent mieux côté Produit : savoir que le comportement étrange du module de facturation est celui sur lequel s'appuie la clôture comptable relève du Product Manager ou du métier. La carte se dessine mieux à deux, et c'est d'ailleurs ce qu'on a observé sur une de nos missions Product Builder, qui conernait un backoffice MedTech avec dix ans de code derrière lui, où la fiabilité primait sur la vitesse. Le dispositif associait justement un PM et deux développeurs AI-native, et c'est cette association qui a permis à l'équipe de fonctionner.
Que faut-il documenter pour un agent IA sur un produit existant ?
Il faut écrire pour l'agent les règles et les raisons absentes du code : les subtilités du métier, les raisons d'un choix d'architecture, les contraintes externes et l'histoire des solutions qui paraissent absurdes sans leur contexte. Osmani résume cette idée en une consigne : écrire ce que le code ne peut pas dire, et rien d'autre. Décrire à nouveau l'organisation du code dans un fichier d'instructions revient à expliquer à l'agent ce qu'il aurait trouvé seul.
Sur les zones jaunes et rouges, Osmani demande un livrable de plus avant toute modification, qu'il appelle une note de compréhension. L'agent lit le code sans rien toucher et consigne ce qu'il a compris : par où l'on entre dans le module, qui en est responsable, ce qui en dépend, quels tests existent, ce que l'historique en dit et quelles questions restent ouvertes. Chaque affirmation renvoie à une preuve, un fichier ou un ticket par exemple. Sans cette note, le travail de compréhension disparaît avec la session, et l'agent suivant doit tout recommencer.
Shopify a appliqué une étape comparable pour la migration de son application Shop vers de nouvelles technologies. Des agents spécialisés étudiaient d'abord l'ancienne application et documentaient son comportement, écran par écran, avant de proposer un plan. Les ingénieurs relisaient chaque plan avant que les agents ne l'exécutent, et toute modification du plan annulait sa validation.
La planification repart ensuite d'une page propre, et c'est un humain qui choisit l'approche. Si l'agent découvre en cours de route que la carte était fausse, le travail s'arrête. La relecture repart des critères d'acceptation, confiée à un relecteur qui n'a pas participé à l'écriture : il repère mieux un test qui valide le code tout en passant à côté du besoin. L'équipe de Bun a fait de même, ses agents relecteurs recevant uniquement les modifications, sans le raisonnement de l'agent qui les avait écrites.
Rédiger ces critères, et une bonne partie de la note de compréhension, suppose une connaissance métier que le code ne contient pas. Sur un produit existant, le travail de spécification du Produit devient une matière première directe du travail des agents.
Comment transformer les corrections répétées en garde-fous ?
Quand on corrige plusieurs fois la même erreur d'un agent, la correction doit quitter la conversation pour rejoindre l'environnement de travail de l'agent, ce qu'on appelle le harness (ses instructions, ses outils, ses droits d'accès, ses tests). Chaque correction répétée signale une pièce manquante du harness.
Le test se joue au moment où l'agent se trompe. Si on corrige discrètement son travail, la session suivante peut refaire la même erreur. Quand la même remarque revient en relecture, elle gagne à devenir une vérification automatique, qui bloque l'erreur avant qu'elle n'arrive chez un humain. Les consignes écrites restent pour ce qu'aucun outil ne sait contrôler, et une règle automatique s'applique même quand tout le monde l'a oubliée - si ça vous intéresse, on creuse le sujet dans un guide du harness engineering.
Le récit de la réécriture de Bun, un outil très utilisé par les développeurs JavaScript, en donne un exemple. En cours de route, les agents se sont mis à remplacer les morceaux de code qui ne fonctionnaient pas par des coquilles vides, accompagnées de longs commentaires pour justifier le procédé. Jarred Sumner, le créateur de Bun, a donné une nouvelle consigne aux agents relecteurs : un commentaire d'un paragraphe pour justifier un contournement signifie que le code est faux, et c'est le code qu'il faut corriger. Il rapporte que le problème a disparu en quelques heures.
Pourquoi figer le comportement actuel avant d'y toucher ?
Un test de caractérisation enregistre ce que fait un module aujourd'hui, bizarreries comprises, pour vérifier qu'il continue à le faire après modification. Dans un vieux système, certaines de ces bizarreries font tourner le business. Un agent qui les prend pour des erreurs les "corrige", et les tests existants ne voient rien.
Le terme a été forgé par Michael Feathers dans Working Effectively with Legacy Code, paru en 2004. Il complète le TDD : le TDD écrit le test du comportement voulu, le test de caractérisation enregistre le comportement observé. Sur un produit existant, le second passe avant le premier.
L'agent qui modifie le code ne doit pas être le seul à avoir écrit les tests qui le valident. On fige d'abord le comportement, par un humain ou dans une étape séparée, puis l'agent travaille. Sans cette séparation, les tests valident ce que l'agent vient d'inventer.
La même prudence vaut pour le choix des premières tâches. On commence par faire expliquer un module, écrire ces tests et repérer le code qui ne sert plus, avant de passer à des transformations mécaniques. La grande réécriture attendra.
Quand un système n'a presque aucun test, il reste la comparaison en conditions réelles. Lors de sa migration technique en 2022, Netflix a rejoué des requêtes réelles, celles qui donnent toujours le même résultat, sur l'ancien et le nouveau système pour comparer les réponses. Le reste a été validé en exposant le nouveau système à une petite part des utilisateurs.
Mistral a fait l'équivalent pour son logiciel de simulation. L'ancien et le nouveau programme devaient produire exactement les mêmes valeurs, à des étapes de calcul choisies avec les ingénieurs du client. L'équipe estime que ce dispositif doit faire partie des premières actions de tout projet de modernisation.
Osmani raconte avoir été rappelé un jour de congé, alors qu'il visitait une boutique de comics, parce que la page d'accueil d'AOL.com était cassée. Des dizaines de départements y avaient chacun leurs composants et leurs tests A/B, et les tests automatiques ne couvraient pas tout. Il a fallu vérifier à la main ce qui n'était pas testé. Pour lui, les agents font baisser le coût d'une tentative sur ce genre de page, et le problème des dizaines de départements reste entier. Une page que seul l'usage réel permet de vraiment comprendre est une zone rouge par définition.
Coder avec des agents, en gardant les réflexes Produit. La formation Product Builder for Engineers aide les Software Engineers à cadrer, prioriser et valider leurs idées avant d'écrire la première ligne.
Comment moderniser du code legacy avec des agents IA ?
Une migration se mène par morceaux complets. Un morceau est terminé quand la nouvelle version fonctionne et que l'ancienne a disparu. Si la suppression de l'ancien code est reportée à plus tard, le morceau reste inachevé.
Osmani observe que les migrations à moitié faites désorientent particulièrement les agents. L'agent qui fouille le code trouve l'ancienne façon de faire à quarante endroits et la nouvelle à douze, sans savoir laquelle suivre. Mieux vaut finir complètement une partie, ancien code supprimé compris, avant d'en attaquer une autre.
Les tests habituels ne suffisent pas à prouver qu'une migration a eu lieu. Les chercheurs derrière SWE Refactor Bench ont mis en évidence un biais qu'ils appellent "Blindness" : un agent peut faire passer tous les tests en recopiant simplement l'ancien code, sans rien migrer. Sur 520 essais de migrations menés avec 8 modèles, 28 seulement (5,4 %) ont réellement migré le code sans rien casser.
La complexité du morceau pèse lourd. Une étude de cas menée en entreprise a fait migrer par un agent 12 fonctionnalités d'un ERP en production depuis plus de vingt ans. Le résultat reproduit fidèlement le comportement d'origine dans 92 % des cas pour les fonctionnalités simples, et dans 47 % des cas pour les plus complexes.
| Cas | Ampleur publiée | Comment le résultat a été contrôlé | Source |
|---|---|---|---|
| Bun (2026) | 535 496 lignes réécrites en 11 jours | Plus d'un million de vérifications automatiques existantes, et deux agents relecteurs pour chaque morceau | Bun |
| Mistral (2026) | 40 000 lignes sur 300 000 au premier sprint | Comparaison des résultats de calcul entre ancien et nouveau programme, pilotage par un humain | Mistral |
| Shopify, application Shop (2026) | 12 semaines de la preuve de concept à la publication, noyau de six ingénieurs | Plans relus par les ingénieurs, comparaison écran par écran entre ancienne et nouvelle application | Shopify |
| Stripe (2022) | Plus de 3,7 millions de lignes converties en une seule fois | Un script de conversion automatique, sans agent | Stripe |
| Asana (2026) | Deux semaines, environ 12 000 dollars de coût de calcul | Un ingénieur suit l'avancement deux fois par jour et relit chaque changement | OpenAI |
Mistral a mis trois tentatives à trouver son réglage. Après l'essai en autonomie complète, l'équipe a organisé les agents en rôles : l'un planifie, un autre code, un troisième teste, un quatrième relit. Le code était meilleur, mais les agents restaient bloqués face aux difficultés, sans personne pour les débloquer. La formule retenue place un humain aux commandes, qui fait avancer les agents module par module et fait valider chaque plan par un ingénieur du client.
Le cas de Bun appelle de la prudence. Jarred Sumner a fait réécrire son outil dans un autre langage par jusqu'à 64 agents en parallèle, pour environ 165 000 dollars de coût de calcul. Bun appartient à Anthropic depuis décembre 2025, et Sumner a utilisé un modèle pas encore public. Surtout, Bun disposait de plus d'un million de vérifications automatiques pour contrôler le résultat, un filet de sécurité que peu de produits existants possèdent.
La préparation est plus transférable que le chiffre. Avant de lancer quoi que ce soit, Sumner a passé environ trois heures à rédiger avec l'IA un guide de correspondance entre les deux langages. Il a ensuite testé la méthode sur 3 fichiers avant de l'appliquer aux 1 448. La réécriture a tout de même introduit 19 régressions connues, toutes corrigées selon l'équipe.
Stripe a mené sa migration de 2022 avec un script de conversion automatique, sans agent. Osmani en tire une répartition qu'on partage : le script fait le travail routinier, et l'agent aide à l'écrire avant de s'occuper des cas particuliers. Pour Asana, il rappelle que les 12 000 dollars annoncés correspondent uniquement au coût de calcul.
Quand faut-il faire travailler plusieurs agents en parallèle ?
Osmani recommande de paralléliser en dernier, et on le rejoint. Il attend pour cela que chaque changement puisse être vérifié et annulé, et que l'équipe arrive à absorber les relectures. Avant ce stade, écrit-il, le parallélisme multiplie le goulot d'étranglement existant.
La relecture est le premier goulot. Des vérifications automatiques absorbent sans peine plusieurs changements en même temps. Un développeur senior qui relit chaque ligne voit la file s'allonger, jusqu'à valider pour la forme. Osmani recommande de lui présenter d'abord l'essentiel : l'intention du changement, ce qu'il modifie, le résultat des tests et la façon d'annuler. L'attention humaine va en priorité là où une erreur coûterait le plus cher.
Le cloisonnement entre agents demande aussi de la vigilance. Donner à chaque agent sa propre copie de travail sépare les fichiers modifiés, alors que les accès et les services partagés peuvent rester communs. Bun l'a vécu en direct : deux minutes après le lancement, les agents se marchaient dessus, certains mettant de côté ou effaçant les modifications en cours des autres. Sumner leur a interdit ces manipulations, puis a réparti le travail en quatre groupes de seize agents.
Shopify décrit la même évolution dans sa façon de travailler : l'équipe fait souvent tourner plusieurs agents en parallèle, chacun dans sa copie de travail. Elle précise que l'expertise de ses développeurs est restée indispensable, car le code généré pouvait remplir la fonction demandée tout en introduisant des doublons ou des écarts d'architecture.
Quels indicateurs suivre pour mesurer l'impact des agents sur un produit existant ?
Pour savoir si un produit s'améliore, Osmani suit le délai de livraison, le temps passé en relecture, le nombre d'interventions humaines, les bugs arrivés en production et les retours en arrière. Pour une migration, il regarde ce qui reste de l'ancien code et la part de l'usage réel qui passe déjà par la nouvelle version.
Des tests au vert pendant que tous les utilisateurs passent encore par l'ancien système ne mesurent que de l'activité.
Les agents mettent un prix visible sur l'ambiguïté, écrit Osmani. Les conventions que personne n'a écrites deviennent des remarques qui reviennent à chaque relecture. Ce coût a toujours existé, payé pendant les relectures et la gestion des incidents, et les agents en rendent une plus grande part mesurable. Pour un Product Manager qui doit défendre la place de la dette technique dans sa roadmap, c'est un argument chiffré qui manquait souvent.
Les tests de caractérisation datent de 2004, et Stripe a converti 3,7 millions de lignes en 2022 sans le moindre agent. Le brownfield agentic engineering reprend cette discipline ancienne et la rend moins chère à tenter. En contrepartie, le flou d'un système se voit désormais sur la facture et dans le temps de relecture. À l'échelle d'une organisation, ces choix touchent au modèle opératoire : c'est le périmètre du volet Plateforme et Agentic Engineering du Product Operating Model AI.
Osmani termine sur un souhait qu'on reprendrait volontiers comme règle pour toute intervention d'agent en zone rouge. La prochaine fois qu'un agent répare l'équivalent de la page d'accueil d'AOL, il devrait laisser derrière lui plus que la réparation : un parcours utilisateur testé automatiquement, le nom du responsable de chaque partie et un test qui empêche le bug de revenir. Ce qu'héritent l'ingénieur et l'agent suivants compte autant que le correctif.
FAQ
Un agent IA peut-il moderniser seul une application legacy en 2026 ?
Les retours détaillés cités dans cet article gardent tous un humain dans la boucle. Chez Mistral, les agents laissés seuls ont produit un nouveau code qui reprenait les défauts de l'ancien, et la formule retenue place un humain aux commandes. Chez Shopify, les ingénieurs relisaient chaque plan avant exécution.
Quelle est la différence entre greenfield et brownfield quand on code avec des agents IA ?
En greenfield, le projet part de zéro et l'équipe qui le lance connaît ses contraintes. En brownfield, une partie des règles vit hors du code, dans la mémoire des équipes ou dans les dépendances d'autres services. L'agent doit les apprendre avant d'écrire, et l'équipe doit vérifier après coup qu'aucune n'a été cassée.
Qu'est-ce qu'un test de caractérisation et pourquoi l'utiliser avec un agent IA ?
Un test de caractérisation enregistre ce que fait un module aujourd'hui, bizarreries comprises, pour vérifier qu'il continue à le faire après modification. Le terme vient de Michael Feathers. Avec un agent IA, il évite de "corriger" sans le savoir un comportement dont le business dépend. Ces tests s'écrivent par un humain ou dans une étape séparée, avant que l'agent ne modifie le code.
Faut-il un fichier d'instructions (AGENTS.md, CLAUDE.md) sur un produit legacy ?
Oui, à condition de le limiter à ce que le code ne dit pas : règles métier, choix historiques, contraintes externes, conventions qu'aucun outil ne vérifie. L'agent comprend seul une bonne partie de l'organisation du code. Les corrections qui reviennent sans cesse gagnent à sortir de ce fichier pour devenir des vérifications automatiques.
Combien coûte une migration de code legacy avec des agents IA ?
Les chiffres publiés restent rares et partiels. La réécriture de Bun, 535 496 lignes, a coûté environ 165 000 dollars de calcul. Asana annonce environ 12 000 dollars pour un chantier que son plan initial estimait à au moins cinq ans. Ces montants couvrent le coût des modèles, sans le temps humain passé à préparer et à relire.
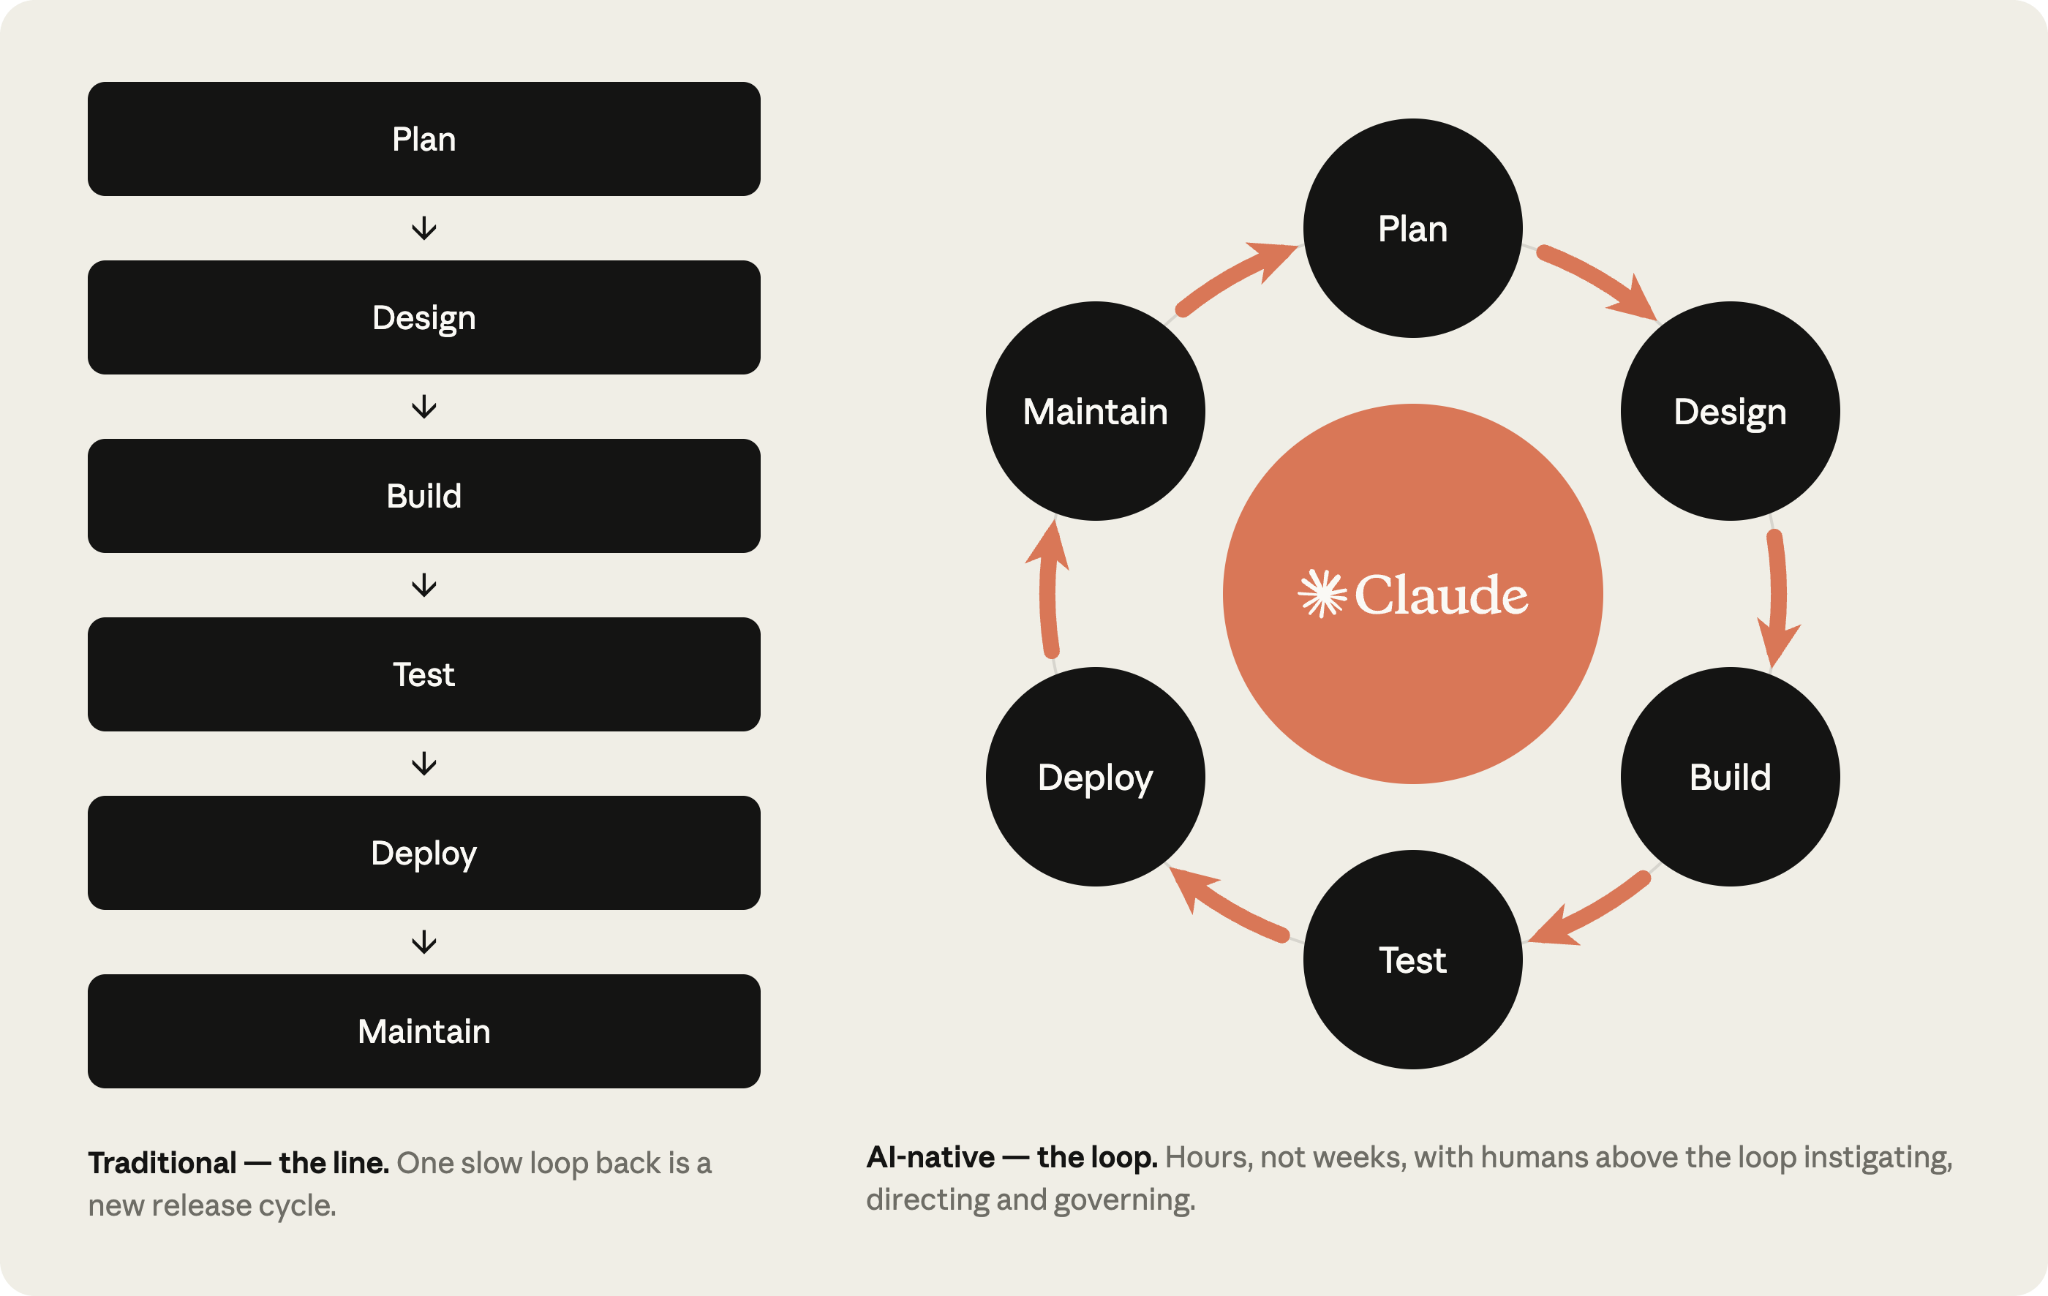
Et si c'était le cycle de développement lui-même qu'il fallait revoir ? Notre décryptage de l'AI-DLC explique comment AWS propose de rebâtir le SDLC autour des agents, legacy compris.